KI und Forschung – vereint beim ersten HFMI-Workshop
Rund 150 führende Köpfe an der Schnittstelle zwischen künstlicher Intelligenz (KI) und Forschung haben sich kürzlich in Berlin getroffen, um das transformative Potenzial von KI in verschiedenen wissenschaftlichen Disziplinen zu fördern. Organisiert wurde der Workshop von der Helmholtz Foundation Model Initiative (HFMI), die drei Jahre lang insgesamt 28 Millionen Euro für die Entwicklung von Foundation Models bereitstellt, und dem European Laboratory for Learning and Intelligent Systems (ELLIS), einem europaweiten KI-Netzwerk. Weitere Partner haben den Workshop unterstützt.
Im Interview erläutert Professorin Dagmar Kainmüller, die Leiterin der Arbeitsgruppe „Biomedizinische Bildanalyse“ am Max Delbrück Center, wie der Workshop die Ziele der HFMI unterstützt, und erklärt, wie ihre eigene Forschung aussieht. Kainmüller ist Co-Sprecherin der HFMI Synergy Unit, die den Aufbau nachhaltiger und synergistische Foundation Models koordiniert, und hat den Workshop organisiert. Das Max Delbrück Center ist an der HFMI beteiligt und hat 5,5 Millionen Euro der Förderung erhalten.
Die Referent*innen gehören zu den Stars ihrer jeweiligen Fächer, darunter anderem Expert*innen von Meta, Microsoft, der ETH Zürich, der Simons Foundation, ELLIS und anderen renommierten Institutionen. Professor Stefan Bauer, Datenwissenschaftler der Helmholtz AI – Artificial Intelligence Cooperation Unit, und Mitglied der HFMI Synergy Unit, war maßgeblich daran beteiligt, die hochkarätigen Vorträge zu organisieren.
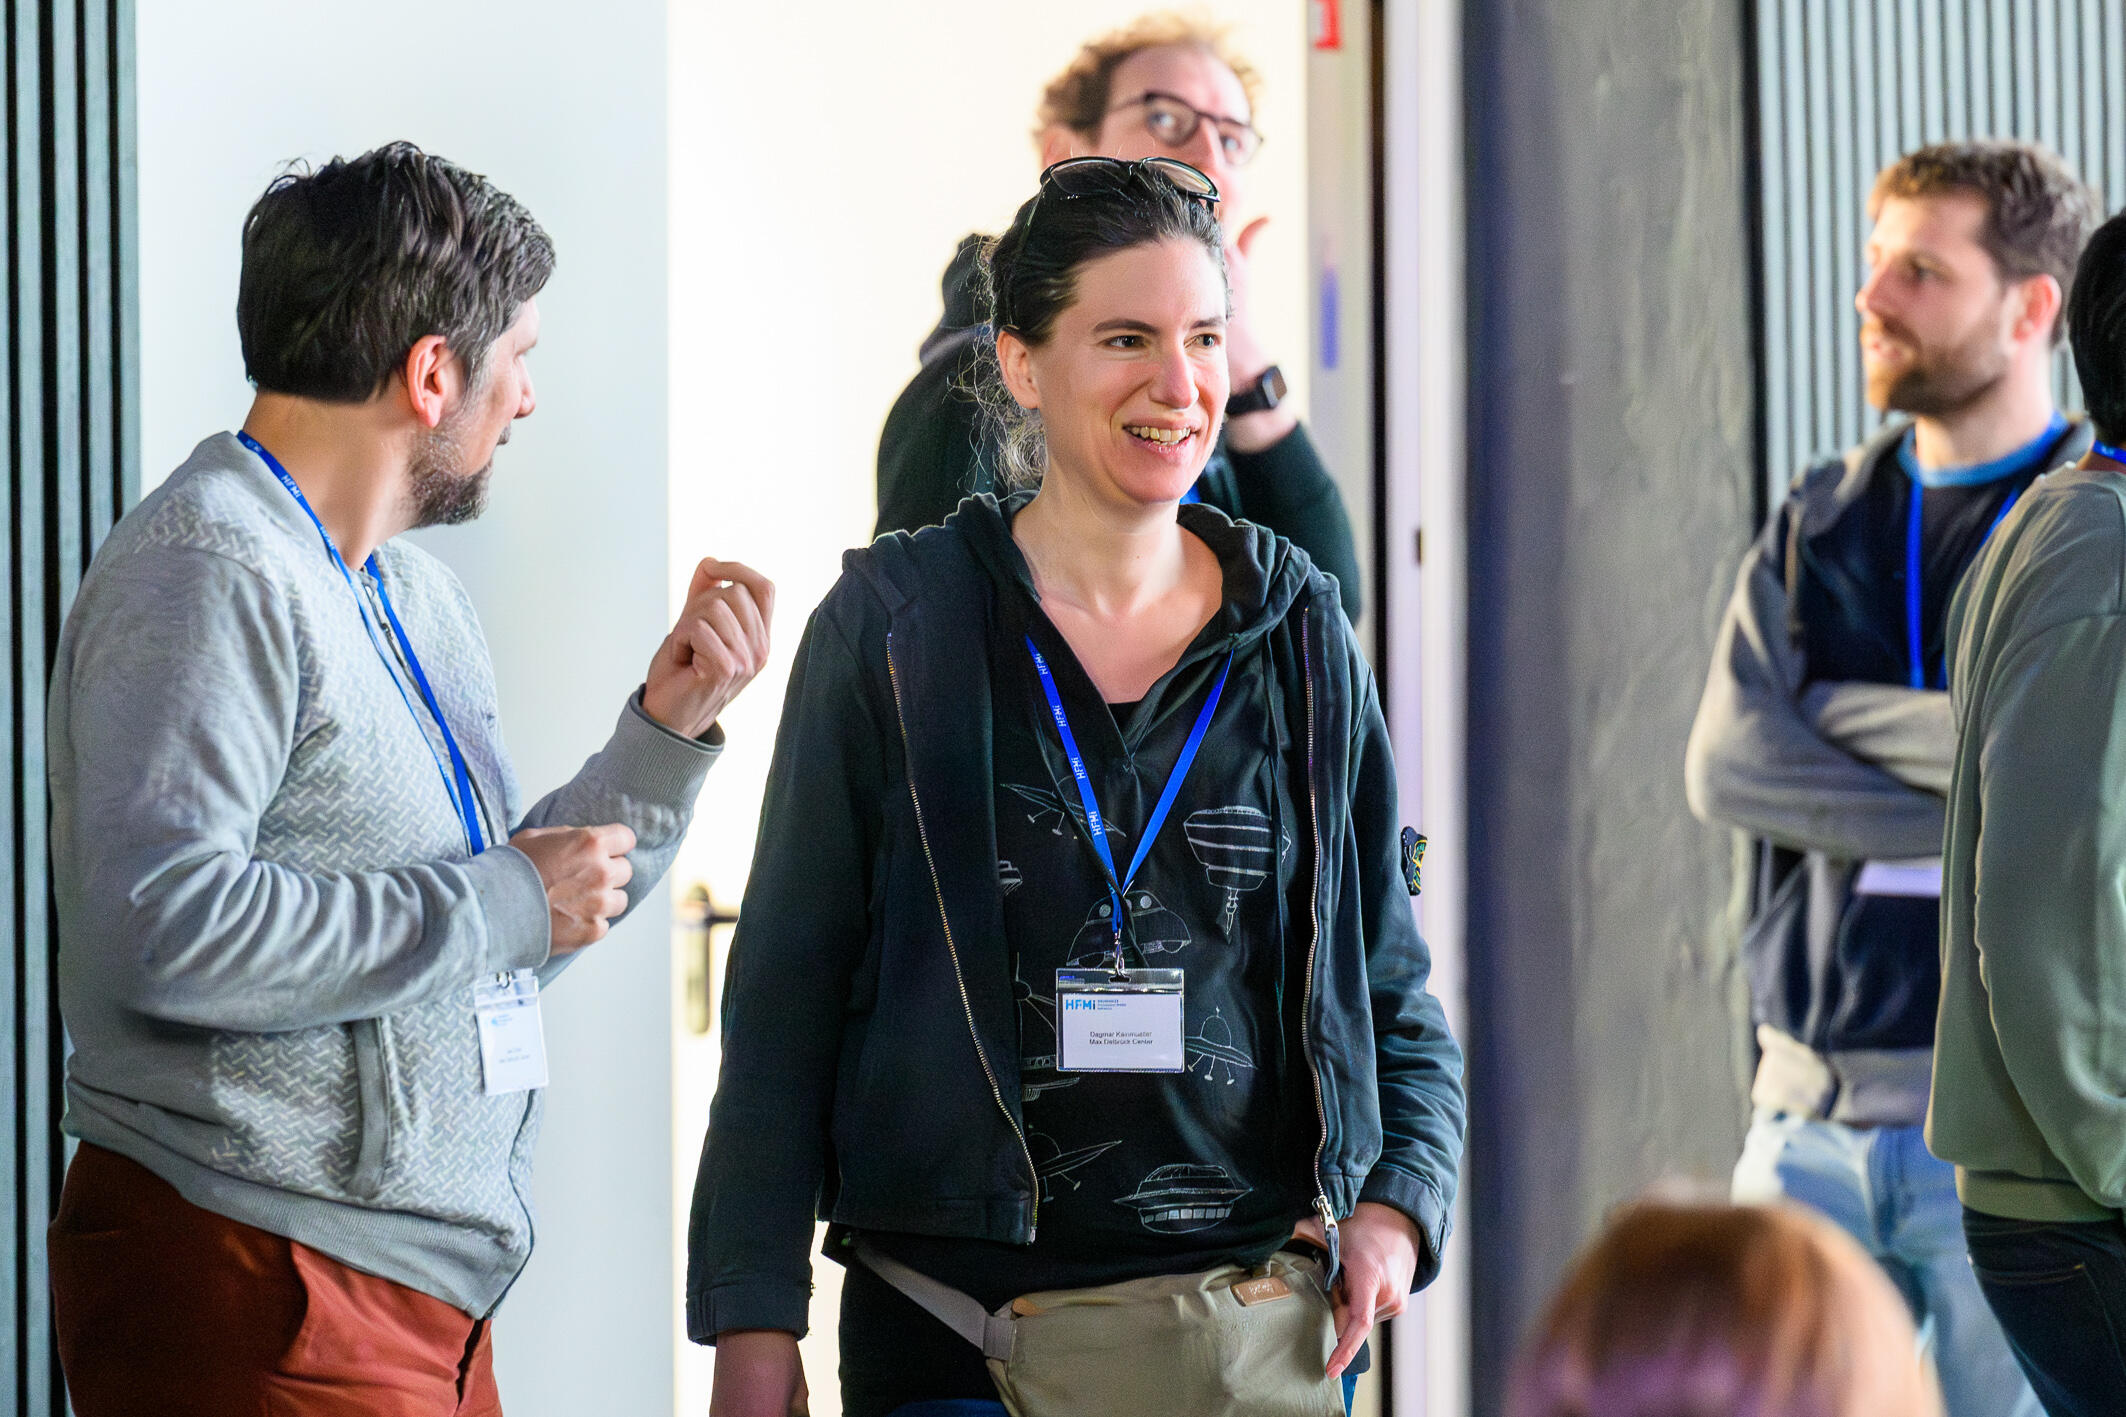
Dagmar Kainmüller und Uwe Ohler (links) während des HFMI-Workshops.
Frau Professorin Kainmüller, was war das Ziel des Workshops?
Dagmar Kainmüller: Wir wollten die weltweite Community, die an Foundation Models für die Wissenschaft arbeitet, zusammenbringen, sie stärken, erweitern, nächste Schritte überlegen – und vielleicht auch in Richtungen zu denken, die etwas ausgefallener sind.
Die Referent*innen des Workshops kamen aus ganz verschiedenen Feldern, auch Gaming und Astrophysik waren dabei. Welche Erkenntnisse haben Sie ganz persönlich mitgenommen?
Wir haben das Treffen ganz bewusst interdisziplinär gestaltet. Denn oft gibt es Synergien, die man nur entdeckt, wenn verschiedene Disziplinen aufeinandertreffen. Anna Scaife von der University of Manchester hielt zum Beispiel einen Vortrag über Foundational Representations in der Astrophysik. Sie steht vor denselben Herausforderungen wie wir in einem meiner aktuellen Projekte, das sich mit Planktondaten befasst. Ihre Bilddaten erfordern ein verändertes Training der KI-Modelle. Wir haben genau das gefunden, was sie gesehen haben. Also haben wir Ideen ausgetauscht und vielleicht werden wir zusammenarbeiten. Ein solch fächerübergreifender Austausch kann für die Weiterentwicklung dieser Modelle wirklich zentral sein.
Können Sie uns einige Höhepunkte des Workshops nennen?
Was mir an diesem Treffen besonders gut gefallen hat: Die Teilnehmenden waren lösungsorientiert, sie wollen die Wissenschaft voranbringen – und nicht nur irgendeine Benchmark bzw. Konkurrenzmodell überbieten, das für die Forschung letztlich irrelevant ist. Auf den üblichen KI-Konferenzen spielt letztere Kategorie eine große Rolle. Lucas Beyer von OpenAI hat zum Beispiel gezeigt, dass ein beträchtlicher Teil der KI-Gemeinschaft bislang auf ein fragwürdiges Ziel hingearbeitet hat – also auf ein ganz bestimmtes, sehr eng gefasstes Benchmark-Ziel der Computer-Vision-Community. Es war wirklich erfrischend, dass diesen Workshop mit so vielen Leuten zu haben, die sich dem widersetzen, auch wenn es schwer ist. Wir haben das von Beyer gehört. Das Gleiche haben wir von Dr. Lena Maier-Hein vom Deutschen Krebsforschungszentrum und der Universität Heidelberg gehört. Ein Gutachter hat ein Paper von ihr negativ bewertet, weil sie Betrügereien auf dem Gebiet aufgezeigt hatte.

KI-Wissenschaftler*innen erweitern ihr Wissen auf dem HFMI-Workshop zur Verbesserung der künstlichen Intelligenz.
Welche Rückmeldungen haben die Teilnehmenden gegeben?
Ich denke, das war genau die richtige Anzahl an Teilnehmer*innen. Wir wollten den Workshop so strukturieren, dass eine aktive Diskussion mit dem Publikum möglich ist. Das ist gelungen und mich hat das sehr gefreut. Es gab viele interaktive Diskussionen, was bei großen Veranstaltungen leider kein Standard ist. Viele Teilnehmende fühlten sich sicher genug, um sich zu Wort zu melden. Genau das wollten wir erreichen.
Die Idee hinter den Foundation Models ist sehr abstrakt für Laien. Können Sie uns den Hintergrund erklären? Was unterscheidet ein Foundation Model zum Beispiel von einem GPT, also einem Generating Pre-Training Transformer?
Ein GPT ist ein Foundation Model, weil es so viele nachgelagerte Aufgaben lösen kann. Wir nennen das „downstream tasks“. Es kann sich zum Beispiel mit Ihnen unterhalten, es kann coden oder die Mathe-Hausaufgaben machen.
Können Sie ein Beispiel für ein Foundation Model geben, mit denen Forscher*innen am Max Delbrück Center spezifische Aufgaben lösen?
Uwe Ohler, der Leiter der Arbeitsgruppe „Bioinformatik der Genregulation“ bei uns am Max Delbrück Center, arbeitet mit Foundation Models, um Genomdaten zu analysieren. Er will vorhersagen, was die regulatorischen Elemente in der Sequenz sind. Das ist ein Beispiel für eine Aufgabe, die ein Foundation Model machen kann. Es kann aber auch andere Aufgaben lösen und dabei dieselben Daten nutzen.
Nutzen Sie dieses Foundation Model auch in Ihrer Arbeit?
Nein, denn sie beziehen sich auf eine bestimmte Domäne. Es gibt kein großes Modell, dass die ganze molekulare Zellbiologie umfasst. Zumindest noch nicht. Für Bilddaten nutzen wir eine Auswahl verschiedener Foundation Models für die verschiedenen Domänen. Es gibt Foundation Models für Daten aus der Pathologie oder für Multiplex-Daten aus der Bildgebung. Wir wollen, dass die Modelle einen direkten Nutzen für die Forschenden in den verschiedenen Feldern haben und ihnen die Möglichkeit eröffnen, Studien neu zu denken.
Vor welchen Herausforderungen stehen Sie dabei?
An die nötigen Daten zu kommen, ist eine große Herausforderung. Selbst wenn Partner gern ihre Daten untereinander teilen wollen, ist es immer noch schwer, den Zugang zu allen zu bekommen. Manchmal geht es da um Datenschutz. Wenn die Daten öffentlich frei verfügbar sind, kann man sie oft trotzdem nicht einfach runterladen, weil dieser enorme Traffic alles zusammenbrechen lassen würde. Und die Daten müssen kuratiert sein, fehlerhafte Daten müssen beseitigt werden, bevor damit Modelle trainiert werden. Das sind ganz praktische Flaschenhälse, die uns im Moment begegnen. Aber wenn wir erstmal ein gut kuratiertes Datenset haben, dann können wir den KI-Teil schon ziemlich gut lösen. Da würde wohl jeder und jede zustimmen.

Kluge Köpfe durch gesammelte Daten: Ein Vortrag im Rahmen des HFMI-Workshops.
Gibt es noch mehr Herausforderungen?
Manche Expert*innen in der Datenwissenschaft jagen Zielen nach, die anderen Forschenden nichts nutzen. Ihr Ziel löst sich von der Community im jeweiligen Feld, von der Community, die doch das Modell nutzen soll. Sie verwenden enorme Ressourcen darauf, ihre Modelle zu optimieren und das Ergebnis gibt den potenziellen Anwender*innen oft gar nichts. Es ist ein superwichtiger erster Schritt, die Ziele zu definieren, so dass sie für die Wissenschaftler*innen in ihren jeweiligen Feldern von maximaler Relevanz sind.
Auch das wurde im Workshop thematisiert, richtig?
Ja, Sarath Chandar von der Mila Polytechnique in Montréal hat das betont. Er ist sehr skeptisch, wenn in der Autor*innenliste eines Papers zu Foundation Models in der Biomedizin nicht auch Expert*innen für Deep Learning und Biologie stehen. Ich stimme ihm zu. Die Spezialist*innen wissen am besten, was sie mit dem Modell machen wollen.
Auf was freuen Sie sich am meisten?
Es ist ein Privileg, in der HFMI Synergy Unit mit so herausragenden Kolleginnen und Kollegen zusammenzuarbeiten. Da möchte ich besonders Stefan Bauer (HFMI Synergy Unit und Helmholtz Munich) hervorheben, der es geschafft hat, diese tollen Sprecher*innen zu unserem Workshop einzuladen. Alle, mit denen ich in der HFMI kooperiere und die ich treffe, geht es um das große Ganze, sie wollen die Forschung vorantreiben. Das macht unsere Zusammenarbeit nicht nur besonders effektiv, sondern auch sehr angenehm. Ich lerne so viel! Spannende neue Methoden, fantastische Anwendungen, coole Engineering-Tricks. Ich freue mich sehr darauf, wie es weitergeht!
Interview: Gunjan Sinha
Weiterführende Informationen
- Zum Workshop: Agenda und Sprecher*innen
- HFMI
- Mehr als ChatGPT: Foundation Models für die Forschung
- Helmholtz-ELLIS Workshop: Trends in der KI-Forschung
- The Helmholtz-ELLIS Workshop Explored the Role of Foundation Models Across Diverse Research Fields (nur Englisch)